大模型知道自己的思维链推错了吗?
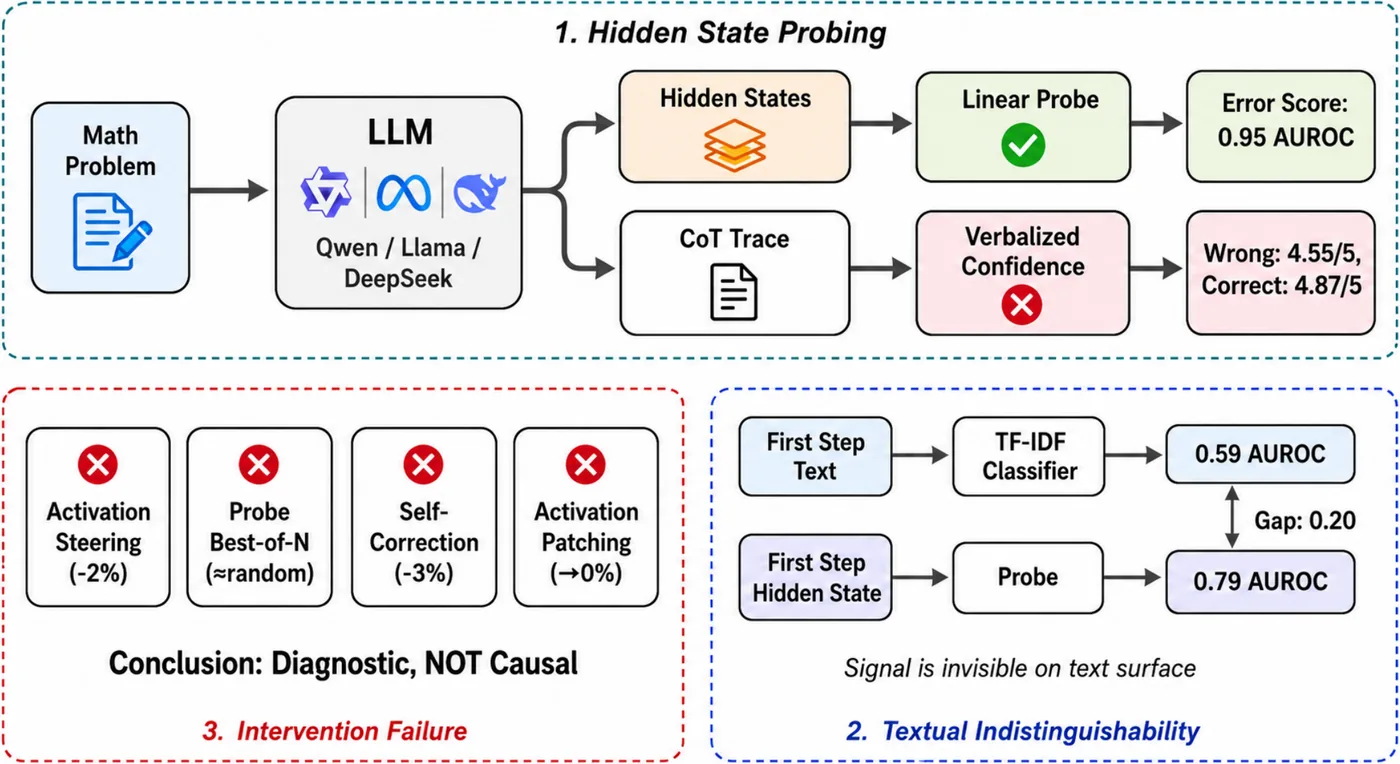
图:论文原图(arXiv:2605.09502)
思维链提示有一个前提:模型写出来的推理反映了它内部真实的计算。这篇论文表明,这个前提以一种具体、可测量的方式失效了——模型知道自己的推理在出错,却不说出来。
“知道”与“说出来”之间的落差
- 隐藏状态上的线性探针预测推理正确性的 AUROC 为 0.95,第一步就有 0.79;
- 口头置信度几乎不变:错误推理 4.55/5,正确推理 4.87/5;
- 只看生成文本的分类器仅 0.59——错误信号在输出里几乎看不见。
这一现象在三个模型家族(Qwen、Llama、Phi)、1.5B 到 72B 参数,以及强化学习训练的推理模型上都成立(DeepSeek-R1 的 AUROC 为 0.852)。
能用这个信号纠错吗?不能
- 激活引导(activation steering)
- 探针引导的 best-of-N
- 自我纠错
- 激活修补(activation patching)——它会彻底破坏输出的连贯性
四种干预全部失败。
这个信号是计算质量的读数,而不是改变计算方向的杠杆。
意义
对可靠性而言,这是有用的:一个廉价的探针可以在你依据推理行动之前标记出可能错误的推理,自然地接入校验智能体或人工复核。对可解释性而言,它划出了一条边界:推理中的错误表示与过去被成功编辑的事实知识表示是不同的。
常见问题
大模型知道自己的推理错了吗?
在内部基本知道:隐藏状态上的线性探针预测思维链正确性的 AUROC 达 0.95,而模型对错误答案的口头置信度仍然很高(4.55/5,正确时为 4.87/5)。
能用隐藏的错误信号来纠正推理吗?
在这项研究中不能:激活引导、探针引导的 best-of-N、自我纠错和激活修补全部失败;这个信号是诊断性的,不是因果性的。
DeepSeek-R1 这类推理模型也有这种现象吗?
有。该现象在 Qwen、Llama、Phi(1.5B–72B)以及强化学习训练的推理模型中都存在,DeepSeek-R1 的 AUROC 为 0.852。
本文基于论文 Hidden Error Awareness in Chain-of-Thought Reasoning: The Signal Is Diagnostic, Not Causal(arXiv 2026,arXiv:2605.09502),作者:Aojie Yuan(袁傲杰)、Zhiyuan Julian Su、Haiyue Zhang、Yi Nian、Yue Zhao。袁傲杰为本文一作。作者主页:袁傲杰 · USC Fortis Lab。