什么是自我进化的事实校验智能体?
一句话回答 —— 自我进化的事实校验智能体会检查 AI 的论断是否真的被所引来源支撑,并输出结构化判定——证据对齐、逐步推理链、校准后的置信度和带类型的错误诊断——再用强化学习改进自己的校验策略。SEVA 的关键是过程奖励:给“校验是怎么做的”打分,恢复了被简单对错奖励抹掉的学习信号。
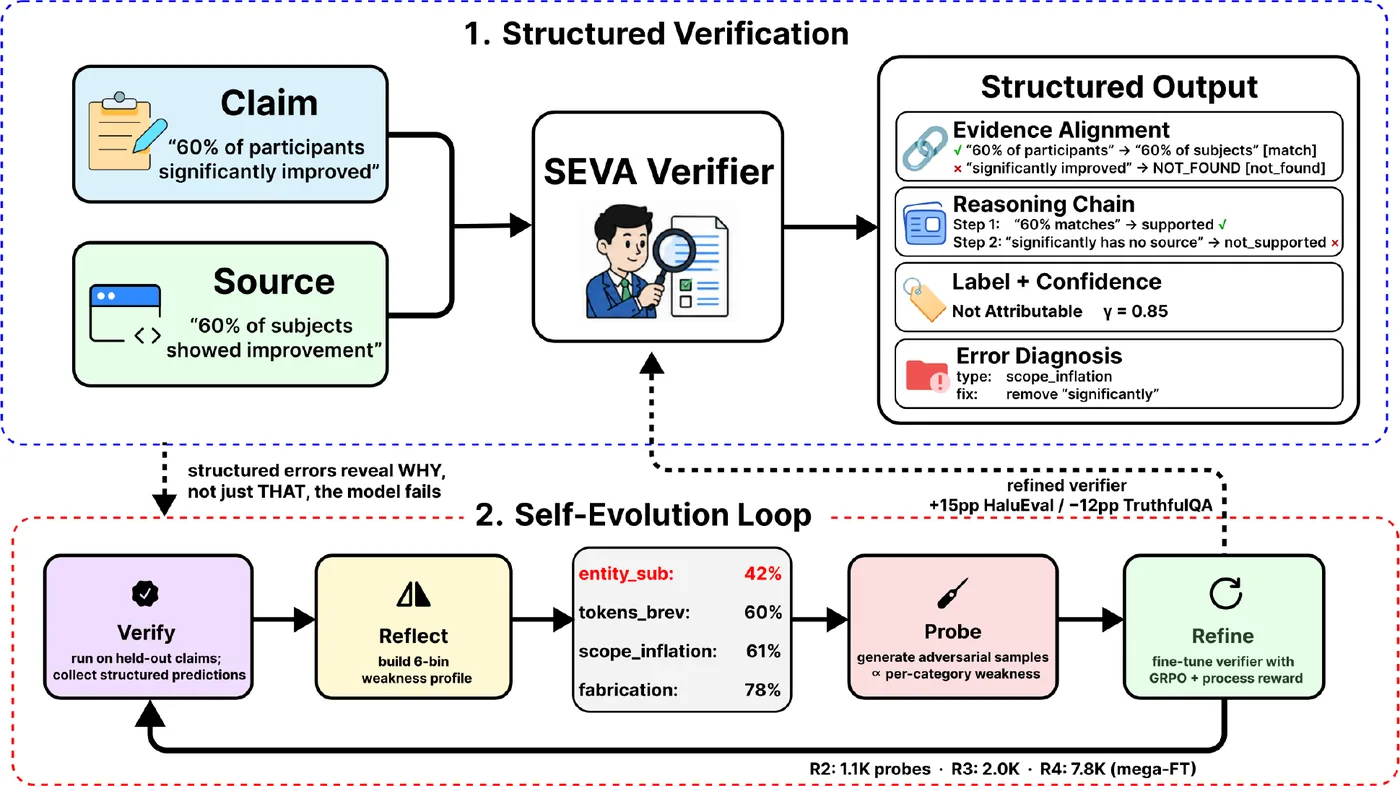
图:论文原图(arXiv:2606.29713)
幻觉是基于大模型的智能体最主要的可靠性瓶颈。当智能体给出带引用的回答时,仍需要有人(或者某个系统)去问:这条论断真的被那个来源支撑吗?这就是事实归因,也是错误答案被采信前的最后一道防线。
它输出什么
- 证据对齐:来源中的哪些片段支撑(或不支撑)论断的哪些部分;
- 推理链:逐步的检查过程,判定可被检查;
- 标签与置信度:支持 / 不支持 / 未找到,并附校准分数;
- 错误诊断:6 类错误类型之一,以及可操作的修正建议。
什么是过程奖励,为什么重要
直觉做法是只在最终标签正确时给奖励。问题在于:很多样本上所有采样都给出同一个答案,优势值塌缩到接近零,梯度消失,模型停止学习。
奖励过程,而不只是奖励结论。
过程奖励把校验质量拆成多个独立分量(证据对齐、错误类型是否正确、校准等),并让分数偏向过程信号(过程与结果大约 70/30)。即便标签一致,不同采样在“怎么校验”上仍有差异,优势值重新拉开,学习得以继续。
为什么叫“自我进化”
有了过程奖励,智能体可以自己产生训练信号:校验、给校验打分、更新——不需要越来越多的人工标注,就能越来越准确地识别论断与证据脱节的方式。
常见问题
什么是自我进化的事实校验智能体?
检查 AI 论断是否被来源支撑、输出结构化判定,并用强化学习持续改进自身校验策略的系统。
什么是过程奖励?
对校验过程质量打分的奖励,拆成多个独立分量并偏向过程信号,可防止优势塌缩、保持学习梯度。
事实归因为什么重要?
幻觉是大模型智能体最主要的可靠性问题,事实归因校验是判断每条论断是否有证据支撑的最后一道防线。
本文基于论文 SEVA: Self-Evolving Verification Agent with Process Reward for Fact Attribution(AI4GOOD & FAGEN @ ICML 2026,arXiv:2606.29713),作者:Aojie Yuan(袁傲杰)、Yi Nian、Haiyue Zhang、Zijian Su、Yue Zhao。袁傲杰为本文一作。作者主页:袁傲杰 · USC Fortis Lab。