大模型用英文、代码和数学推理时,内部是同一套表示吗?
一句话回答 —— 基本是。在 5 个大模型(1.6B–8B)中,同一个推理概念无论写成英文、Python 代码还是数学符号,都落在中间层一个共享的格式无关推理子空间(FARS)里。一个 10 维子空间把概念结构放大约 3 倍、同时把格式信息压到接近零;跨格式修补时只替换这 10 维,就能保留 90–96% 的模型输出,而替换全部激活只能保留 44–56%。主要分歧在陈述式与过程式之间,而不是自然语言与形式语言之间。
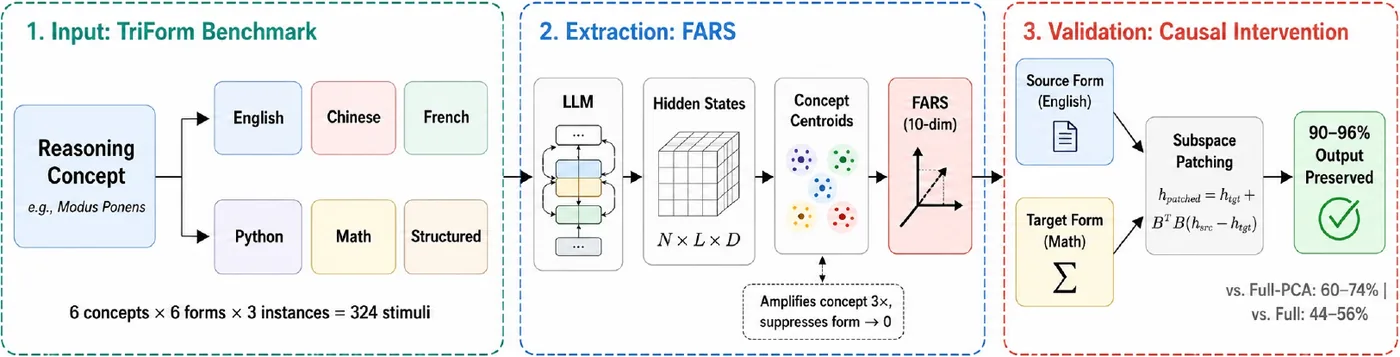
图:论文原图(arXiv:2605.09496)
“如果开关打开,灯就亮”可以写成一句英文、一行 Python 或一个公式。大模型把它们表示成一个概念,还是三个?
TriForm 基准
论文提出 TriForm:18 个概念 × 6 种形式 × 3 个实例 = 324 个刺激,在三个架构家族的 5 个大模型(1.6B–8B)上,用置换校正的 RSA、跨格式探针和激活修补进行研究。
一个 10 维的共享子空间
- 只替换这 10 维的跨格式修补保留 90–96% 的模型输出;
- 替换全部激活只保留 44–56%,按方差最大化的 PCA 为 60–74%;
- 消融这个子空间会造成有针对性的破坏;
- FARS 能泛化到未见过的概念,并在不同架构之间收敛(所有模型对的 CCA > 0.79),为柏拉图表示假说提供了模态内证据。
陈述式与过程式
关键的分歧轴不是自然语言与形式语言,而是陈述式与过程式。
散文与数学之间的表示兼容性,远高于它们与代码之间。后续论文《Concept Subspaces Compute Beyond the Logit Lens》进一步检验了 FARS 与模型输出读出方向的关系。
常见问题
什么是格式无关推理子空间(FARS)?
大模型中间层的一个 10 维子空间,用概念中心 PCA 提取,无论推理概念写成散文、代码还是数学符号,都以相同方式编码。
大模型在自然语言、代码和数学之间共享表示吗?
基本共享:在 5 个大模型中,跨格式修补时只替换 10 个 FARS 维度就能保留 90–96% 的输出,远高于替换全部激活的 44–56%。
哪种格式在模型内部差别最大?
代码。散文和数学彼此更兼容,说明关键分歧是陈述式与过程式。
本文基于论文 Beyond Language: Format-Agnostic Reasoning Subspaces in Large Language Models(arXiv 2026,arXiv:2605.09496),作者:Aojie Yuan(袁傲杰)、Zhiyuan Su。袁傲杰为本文一作。作者主页:袁傲杰 · USC Fortis Lab。