大模型推理一定要把全部 KV cache 放在 HBM 里吗?
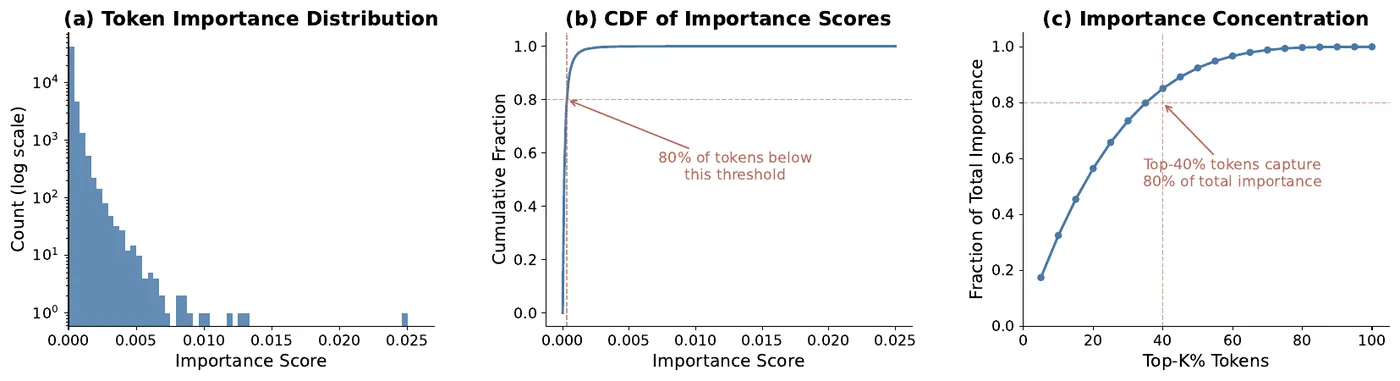
图:论文原图(arXiv:2605.09490)
推理模型靠“想得更久”变强。但每多想一个 token,KV cache 就多一条,而 KV cache 存在 HBM——GPU 上又快又小的显存里。长思维链动辄数千 token,缓存一路增长直到 HBM 耗尽。常见的做法是驱逐 token,而这很危险。
为什么不能直接删 token
现在看起来不重要的 token,可能正是之后注意力需要的那个。永久驱逐推理 token,在难题上可能让准确率趋近于零——模型真的忘了它需要的一步。所以问题不是“哪些 token 可以扔掉”,而是“每个 token 都必须放在最贵的内存里吗?”
机会在哪里
- 重要性分布是重尾的,少数 token 占主导;
- 约 80% 的 token 低于一个很低的重要性阈值;
- 重要性前约 40% 的 token 承载约 80% 的总重要性。
分层,而不是缩减
每个 token 都保留——只是不都放在 HBM 里。
语义感知的内存分层按重要性把 KV 条目放在不同层级:热的高重要性 token 在 HBM,冷的放到 DDR 和压缩存储。关键在于,低重要性 token 会在读取它们的注意力步骤之前被预取回来,模型计算的内容与什么都没离开 HBM 时一致。这就是经典的“快而小 / 慢而大”存储层次,用 token 语义而不只是时近性来决定放置位置。
常见问题
长推理为什么会耗尽显存?
每生成一个 token 都会增加存放在 HBM 中的 KV cache;长思维链产生数千 token,即使大部分贡献很小也会占满 HBM。
什么是语义感知的内存分层?
按重要性对 token 排序并分层存放:重要的少数放 HBM,其余放更便宜的层级,并在需要前预取回来。
这和 KV cache 驱逐有什么区别?
驱逐会删除 token、可能严重损害准确率;分层保留每个 token,只是更便宜地存放、按需取回。
本文基于论文 Not All Thoughts Need HBM: Semantics-Aware Memory Hierarchy for LLM Reasoning(arXiv 2026,arXiv:2605.09490),作者:Aojie Yuan(袁傲杰)、T. Shen、D. Zhang。袁傲杰为本文一作。作者主页:袁傲杰 · USC Fortis Lab。