怎样的 AI 智能体才算“可审计”?
一句话回答 —— 一旦 LLM 智能体能调用工具、产生外部影响,光“防止危害”已经不够——它的行为必须在部署后依然可追责。Auditable Agents 的核心主张是:没有可审计性,任何智能体系统都无法被问责。论文定义了可审计性的五个维度,说明为什么检测、执行、恢复三类机制缺一不可;执行前拦截加防篡改记录的中位开销仅 8.3 毫秒。
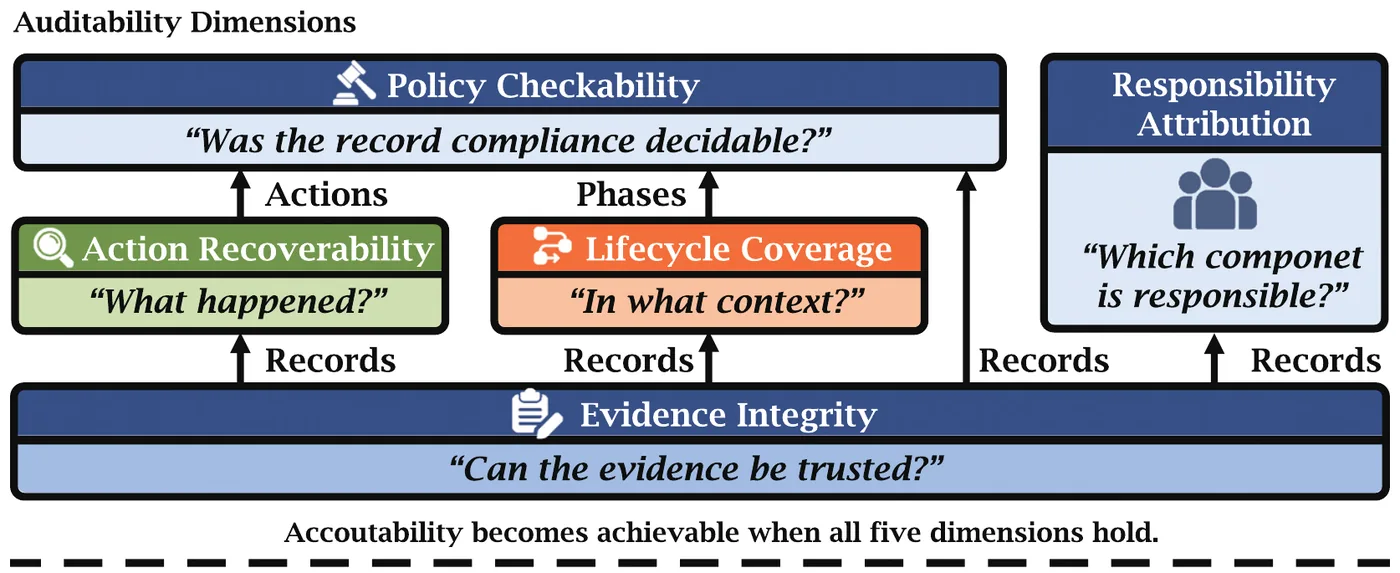
图:论文原图(arXiv:2604.05485)
LLM 智能体会调用工具、查询数据库、委派任务、触发外部副作用。多数安全研究问的是:有害动作能不能被阻止?这篇论文追问的是部署之后马上就会遇到的另一个问题:出事之后,能不能查清智能体做了什么、是否合规、责任在谁?
问责、可审计性、审计
- 问责(accountability):判断是否合规并归属责任的能力;
- 可审计性(auditability):让问责成为可能的系统属性;
- 审计(auditing):依据可信证据重建行为的过程。
没有可审计性,就没有可问责的智能体系统。
可审计性的五个维度
- 动作可恢复性:能否还原智能体实际做了什么;
- 生命周期覆盖:证据是否覆盖部署前、运行时、部署后;
- 策略可检查性:动作能否对照明确策略检查;
- 责任归属:结果能否追溯到具体的智能体、工具或人;
- 证据完整性:记录是否防篡改。
为什么单一机制不够
机制分为检测、执行、恢复三类,各自受限于“何时掌握信息”和“何时还能干预”:执行在动作前起作用但看到的上下文少;检测看到的多但可能已来不及阻止;恢复只能事后依靠残存证据。实际部署需要三者同时存在。
证据
- 生态现状:对 6 个知名开源智能体项目的下界测量发现 617 个安全问题,连可审计性的基本前提都普遍缺失;
- 运行可行性:执行前拦截加防篡改记录仅增加 8.3 毫秒中位开销;
- 可恢复性:受控实验表明,即使常规日志缺失,与责任相关的信息也能部分恢复。
论文最后提出了智能体系统的可审计性卡片(Auditability Card),并按机制类别列出 6 个开放问题。运行时这一侧的思路,正是执行前审计层 AEGIS 所实现的。
常见问题
什么是智能体可审计性?
让问责成为可能的系统属性:能依据可信证据还原智能体做了什么、对照策略检查、并归属责任。
智能体可审计性有哪五个维度?
动作可恢复性、生命周期覆盖、策略可检查性、责任归属、证据完整性。
运行时审计的开销大吗?
论文的可行性实验中,执行前拦截加防篡改记录的中位开销仅 8.3 毫秒。
本文基于论文 Auditable Agents(KnowFM @ ACL 2026 · ACM AI Summit 2026,arXiv:2604.05485),作者:Yi Nian、Aojie Yuan(袁傲杰)、Haiyue Zhang、Jiate Li、Li Li、Xiyang Hu、Hua Wei、Xiongye Xiao、Chaowei Xiao、Yue Zhao。袁傲杰为本文二作。作者主页:袁傲杰 · USC Fortis Lab。