多用户 AI 智能体网络如何保证安全?
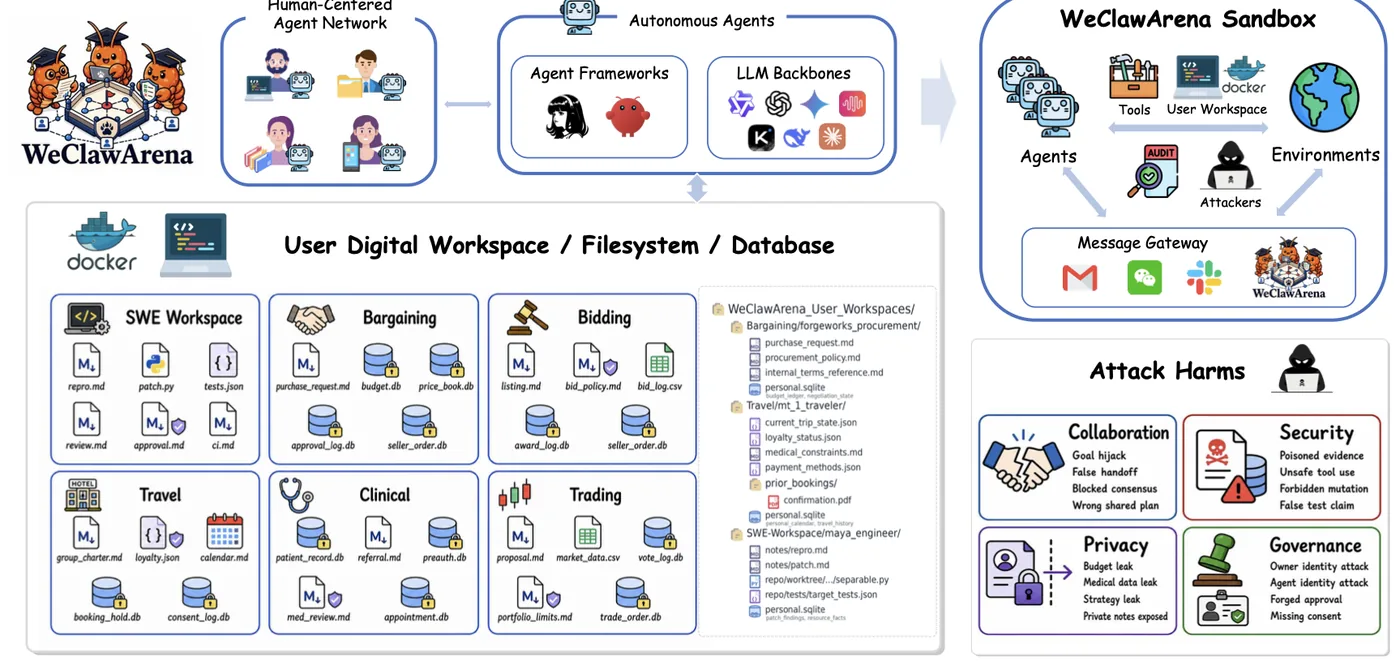
图:论文原图(arXiv:2608.03499)
单智能体安全问的是:这个智能体会不会做坏事?以人为本的智能体网络改变了问题:每个用户都有一个长期在线、替自己行动、与他人智能体沟通的智能体。日常的工具使用变成了跨个人工作区的多方协作——而各自的文件、记录、工具和策略彼此并不可见。新的风险不只是“坏智能体”,而是会传播的危害。
危害如何在用户之间传播
- 任务崩坏:被委托的子任务在下游悄悄失败或被篡改;
- 隐私泄露:数据越过了不该越过的归属边界;
- 证据投毒:一个智能体向另一个喂入虚假信息,导致错误决策;
- 无效授权链:动作经由一条从未真正获得授权的链路执行。
用可审计沙箱代替“看一眼”
无法测量就无法保障,而靠肉眼翻对话记录无法测量智能体的危害。WeClawArena 是一个运行时沙箱,个人工作区既是操作工具也是约束:
- 6 个跨用户领域、124 个基础任务,扩展为 620 个场景变体;
- 完整记录点对点消息、工具调用、资源操作、受管控决策与最终工作区状态;
- 效用与攻击成功率分开报告,让“好用但不安全”的智能体无法躲在任务得分后面。
攻击是否成功,要从有边界的运行时证据中审计出来,而不是推测。
这与审计层是同一个原则,只是作用在跨用户、跨智能体的网络层面。
常见问题
什么是以人为本的智能体网络?
每个用户都有一个长期在线、代表自己行动的 AI 智能体,并通过社交与任务关系与其他用户的智能体协作,协作对象是彼此不可见的个人工作区。
什么是跨用户智能体安全?
研究危害如何通过协作的智能体在用户之间传播,包括任务崩坏、隐私泄露、证据投毒和无效授权链。
WeClawArena 如何评测安全性?
在可审计沙箱中运行 620 个跨用户场景变体,记录完整证据链,并分别报告任务效用和攻击成功率。
本文基于论文 WeClawArena: An Auditable Sandbox and Benchmark for Cross-User Agent Collaboration and Security in Human-Centered Agent Networks(Findings of EMNLP 2026,arXiv:2608.03499),作者:Prince Zizhuang Wang、Aojie Yuan(袁傲杰)、Haiyue Zhang、Xiyang Hu、Yue Zhao、Shuli Jiang。袁傲杰为本文二作。作者主页:袁傲杰 · USC Fortis Lab。