为什么决策导向学习常常赢不了 MSE?
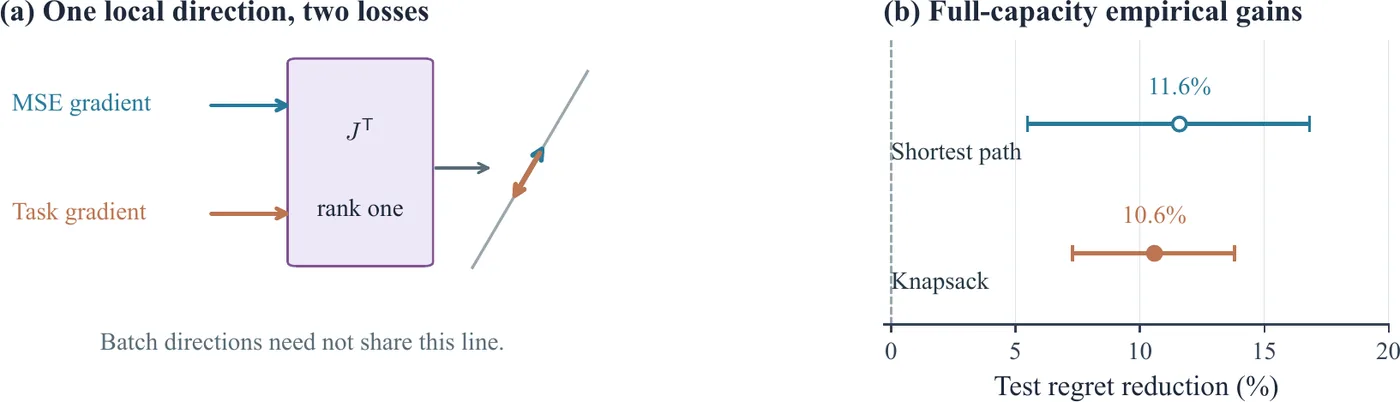
图:论文原图(arXiv:2609.39261)
决策导向学习(DFL)用预测所服务的下游目标——路径成本、组合收益、背包价值——来训练预测器,而不是只看预测误差。直觉上,一个懂决策的损失应该能教会模型 MSE 教不会的东西。这篇论文问:什么时候这真的可能?
一个方向,两种损失
损失只能通过改变参数更新来改变学习。根据链式法则,所有梯度都要经过预测器的雅可比矩阵。如果它是秩一,任何损失给出的每样本非零梯度都在同一条直线上——任务损失只能缩放步长,不能改变方向。条件谱界把这一结论推广到近似共线;批子空间刻画和反例说明,这些局部结论并不意味着存在共同最小点或批更新共线。
不同的损失,未必带来独立的参数更新方向。
实验结果
- 38 个单参数股票配置上,DFL 相对 MSE 的提升都低于 1.8%;一个 385 参数的条件预测器同样是逐点秩一;
- 经验证集调参的最短路径和背包实验中,满容量 SPO+ 把平均遗憾分别降低 11.6% 和 10.6%,8 次比较校正后只有背包问题仍显著;
- 在表达能力不变的前提下,可逆的坐标缩放会降低谱有效秩和普通 SGD 的增益;补偿缩放后能恢复原来的训练轨迹;
- 金融远期目标对照把预测准确率与决策质量区分开;匹配的神经网络对比在所测架构上没有发现整体的 DFL 优势。
实际启示
在换用决策导向损失之前,先检查几何结构:如果预测器每个样本基本只提供一个学习方向,新损失能帮上的忙就很有限。预测器几何解释了哪些方向可用,而留出集上的决策质量才是是否真正有益的检验。
常见问题
什么是决策导向学习?
一种训练方法:预测器以其预测所服务的下游决策质量(例如优化问题中的遗憾)为目标,而不只是预测误差。
为什么决策导向学习有时并不比 MSE 好?
如果预测器的参数雅可比矩阵是秩一,MSE 损失和任务损失给出的每样本梯度共线,任务损失无法提供新的更新方向。
SPO+ 比 MSE 提升多少?
满容量实验中,SPO+ 在最短路径上降低平均遗憾 11.6%,在背包问题上降低 10.6%,但经 8 次比较的 Holm 校正后只有背包问题显著。
本文基于论文 Jacobian Rank Collapse in Decision-Focused Learning(arXiv 2026,arXiv:2609.39261),作者:Aojie Yuan(袁傲杰)、Haiyue Zhang、Zijian Su。袁傲杰为本文一作。作者主页:袁傲杰 · USC Fortis Lab。