AI 智能体如何记住长对话?
一句话回答 —— 智能体记住长历史的方法,是把历史存进外部记忆、按查询检索相关片段,而不是把一切塞进上下文窗口。难点在成本:稠密检索准但慢。AgentIR 采用负载自适应的级联检索——向量化 BM25 阶段约 0.9 毫秒就能回答简单查询并提前返回,只有较难的查询才升级到稠密检索加重排(约 53 毫秒)。平均延迟随查询的真实难度变化。
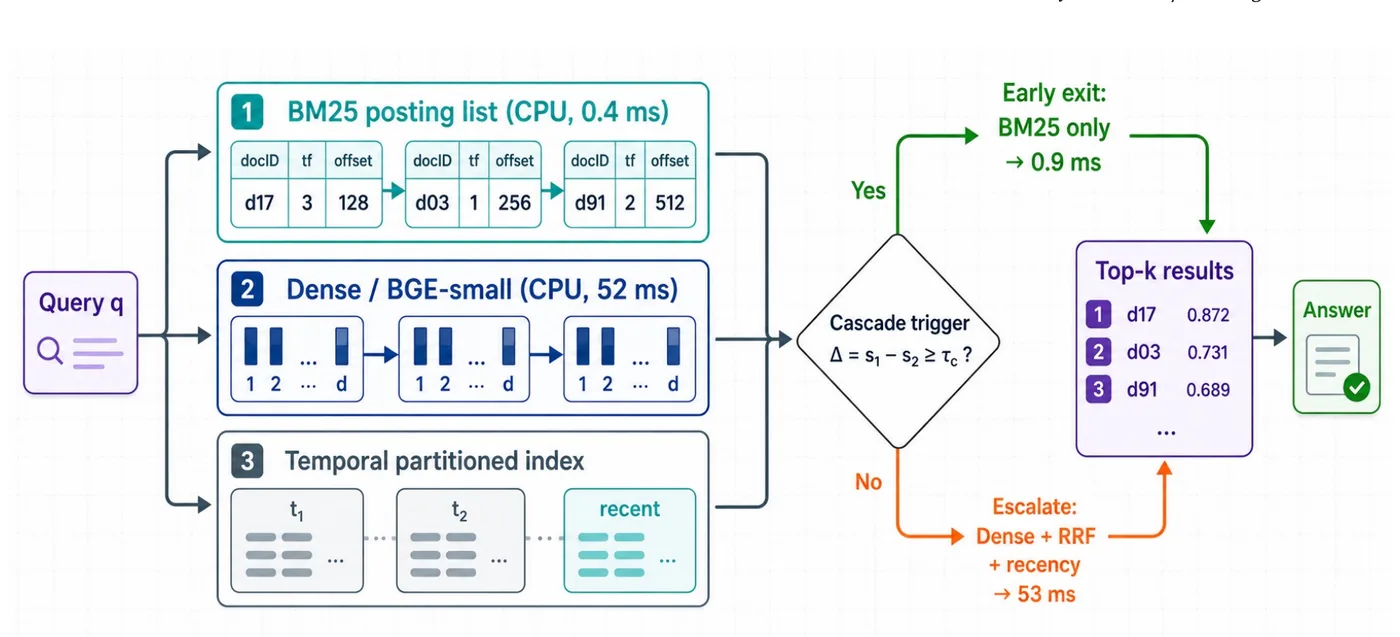
图:论文原图(arXiv:2605.25092)
在上千条消息之后问智能体“我们上周二定了什么?”,它面对的记忆问题不是更大的上下文窗口能真正解决的:窗口有限、每个 token 都有成本、长期运行的智能体历史无限增长。可扩展的答案和搜索引擎几十年前学到的一样——不要全记在脑子里,去检索。
记忆 = 存储 + 检索
- 词法检索(如 BM25)极快但浅,只匹配词;
- 稠密检索(向量)能理解语义,但每次查询更慢更重。
只选一种,要么漏掉换了说法的记忆,要么在每次简单查找上都付出稠密检索的成本。
让检索随查询难度自适应
AgentIR 并行运行三个底层阶段——SIMD 向量化的 BM25 倒排表、稠密 BGE-small 通道和按时间分区的时序索引——由一个级联触发器决定走哪条路:
- 提前退出:BM25 阶段足够有把握(分数差距明显)时,约 0.9 毫秒返回,大多数查询到此为止;
- 升级:否则进入稠密检索,配合倒数排名融合和时近信号(约 53 毫秒)。
查询简单时便宜,查询困难时彻底。
为什么要按时间分区
对话记忆有通用 RAG 忽略的时间轴。“上周二定了什么”是一个时近加时间的查询,而不只是语义查询。按时间分区的索引让检索偏向正确的时间窗口。
常见问题
AI 智能体如何记住长对话?
把历史存进外部记忆,按查询检索相关片段;级联检索器便宜地回答简单查询,只有难查询才升级。
什么是级联检索?
先用便宜的检索器,检查置信度,足够好就提前返回,否则才升级到更昂贵的稠密/重排阶段,让延迟随查询难度变化。
为什么不直接扩大上下文窗口?
上下文有限且按 token 计费,长提示会稀释注意力,而智能体历史无限增长;在存储上检索才能扩展。
本文基于论文 AgentIR: A Workload-Adaptive Cascade Retrieval Substrate for Long-Term Conversational Memory(arXiv 2026,arXiv:2605.25092),作者:Aojie Yuan(袁傲杰)、Haiyue Zhang、S. Nazarian。袁傲杰为本文一作。作者主页:袁傲杰 · USC Fortis Lab。