如何衡量工具调用智能体的“仿真到现实”落差?
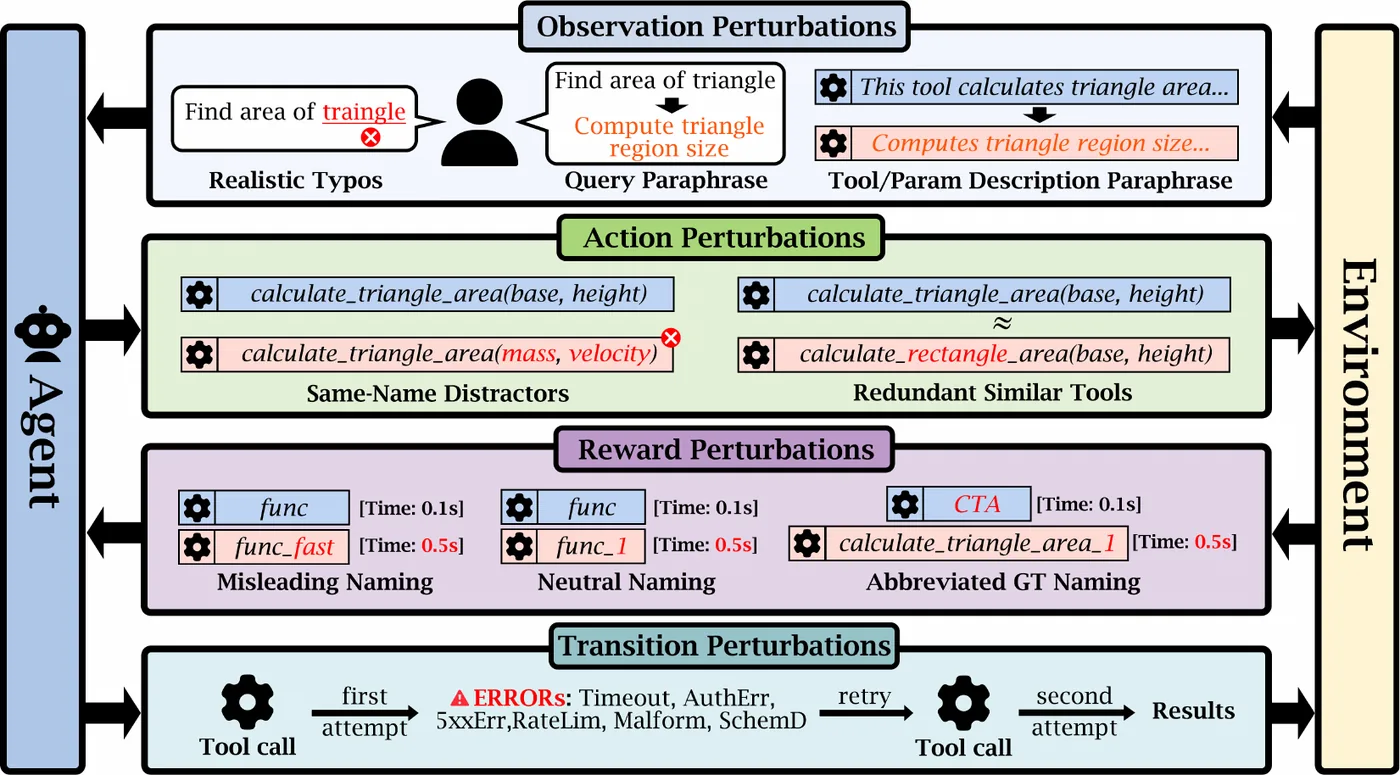
图:论文原图(arXiv:2605.11928)
如果智能体在基准上拿 90 分、上线就崩,说明基准在“撒谎”——不是故意的,而是因为它的假设:输入干净、工具注册表无歧义、API 可靠。真实部署三条全都不满足。
落差从哪里来
借用机器人领域的说法:干净的基准是“仿真器”,混乱的部署是“真实世界”。工具调用环境是一个部分可观测马尔可夫决策过程(POMDP),真实故障对应它的各个部分:
- 观测:用户错别字、换个说法表达目标、工具描述有噪声;
- 转移:不同服务器上的重名工具、超时配置错误、冗余工具;
- 奖励:看起来对、其实不对的干扰工具。
怎么测
RobustBench-TC 按 POMDP 的组成部分组织了 22 种扰动,每一种都来自经核实的 GitHub issue 或有记录的工具调用故障。在 21 个模型(1.5B 到 32B,包括闭源模型)上:
- 观测扰动:准确率下降 < 5%;
- 奖励相关扰动:下降约 40%;
- 转移扰动:下降约 30%。
单靠规模无法弥合这道落差。
怎么补
既然问题出在训练分布,就去修分布。ToolRL-DR 是一套域随机化强化学习方案:在覆盖各个 POMDP 组成部分的扰动增强轨迹上训练智能体,让它不再假设世界是干净的——就像域随机化在机器人 sim-to-real 中做到的那样。
常见问题
工具调用智能体的 sim-to-real 落差是什么?
智能体在干净基准与真实部署之间的性能下降:错别字、超时、重名工具等会扰动工具调用 POMDP 的观测、转移和奖励部分。
哪种扰动影响最大?
观测噪声只造成不到 5% 的准确率下降;奖励层和转移层噪声分别造成约 40% 和 30% 的下降。
怎样提升鲁棒性?
域随机化强化学习:在跨 POMDP 组成部分的扰动增强轨迹上训练智能体。
本文基于论文 When Simulation Lies: A Sim-to-Real Benchmark and Domain-Randomized RL Recipe for Tool-Use Agents(NeurIPS 2026 · FAGEN @ ICML 2026,arXiv:2605.11928),作者:Xiaolin Zhou、Aojie Yuan(袁傲杰)等。袁傲杰为本文二作。作者主页:袁傲杰 · USC Fortis Lab。