电脑操作智能体能做“看得见”的软件工程吗?
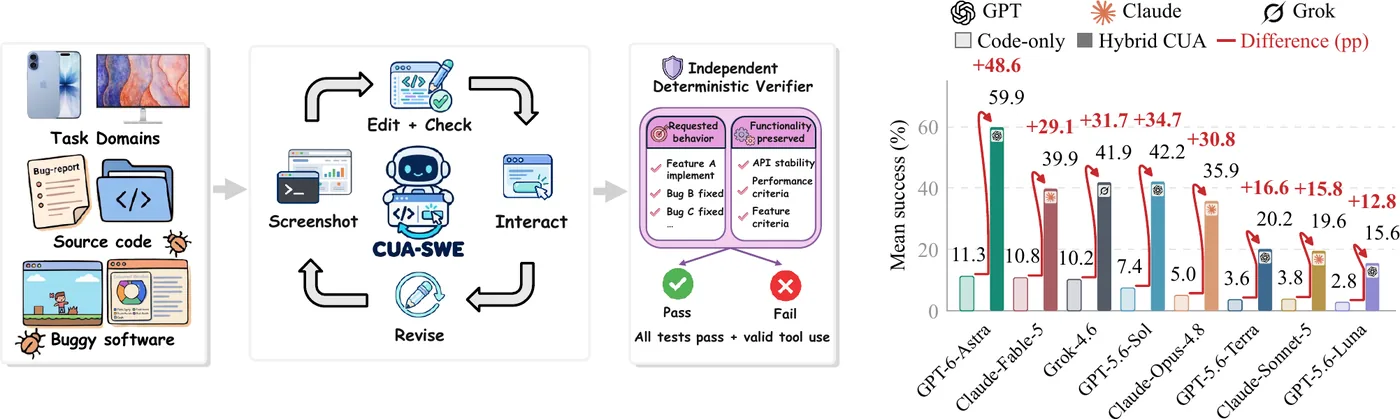
图:论文原图(arXiv:2609.32600)
软件开发不只是改代码。开发者会运行程序、点开界面、观察它的行为,再据此决定改什么、判断修复是否生效。编码智能体和电脑操作智能体(CUA)过去大多被分开研究,这个完整的闭环一直缺少衡量。
CUA-SWE 考什么
在一个任务中,智能体可能需要:
- 修改代码与配置;
- 执行命令;
- 通过图形界面与运行中的软件交互;
- 查看视觉反馈来诊断问题并验证修复。
任务覆盖 4 个软件工程领域;部分任务中,所需的需求或操作信息只能从运行中应用的界面上看到。
用测试验证,而不是让模型打分
每个任务都配有确定性的专属测试,检查修改后的软件是否满足需求、是否保留了既有行为——不靠 LLM 裁判判断修复“看起来对不对”。
纯代码 vs 混合电脑操作
论文图 1 对比了每个前沿智能体的纯代码配置与能看见并操作应用的混合 CUA 配置:8 个前沿智能体中,混合配置把平均任务成功率提高了 12.8 到 48.6 个百分点;最强配置在混合模式下达到 59.9%,纯代码模式只有 11.3%。
面对可视化的软件,看不见应用的智能体等于在盲调。
常见问题
CUA-SWE 是什么?
ICLR 2026 的一个软件工程基准:智能体需要修改代码、执行命令、操作运行中的应用并查看截图,每次修复由确定性测试验证。
电脑操作能力能帮编码智能体修 bug 吗?
在 CUA-SWE 中可以:混合电脑操作配置比纯代码配置的平均任务成功率高 12.8 到 48.6 个百分点(8 个前沿智能体)。
CUA-SWE 如何评分?
使用确定性的任务专属测试,而不是 LLM 裁判。
本文基于论文 CUA-SWE: When Computer-Use Agents Meet Visual Software Engineering(ICLR 2026,arXiv:2609.32600),作者:Prince Zizhuang Wang、Chenhao Liang、Zelong Xu、Aojie Yuan(袁傲杰)、Xiaolin Zhou、Haiyue Zhang、Yue Zhao、Xiyang Hu、Shuli Jiang。袁傲杰为本文合作者。作者主页:袁傲杰 · USC Fortis Lab。