不集中收集原始消息,怎么审计智能体之间的交接?
- 论文
- Auditing Agent Handoffs Without Centralizing Raw Messages: Evidence Boundaries and Release Tradeoffs
- 作者
- Aojie Yuan
- 发表
- Preprints.org 预印本(未经同行评审)
- 阅读
- PDF · DOI · 引用(BibTeX) · English
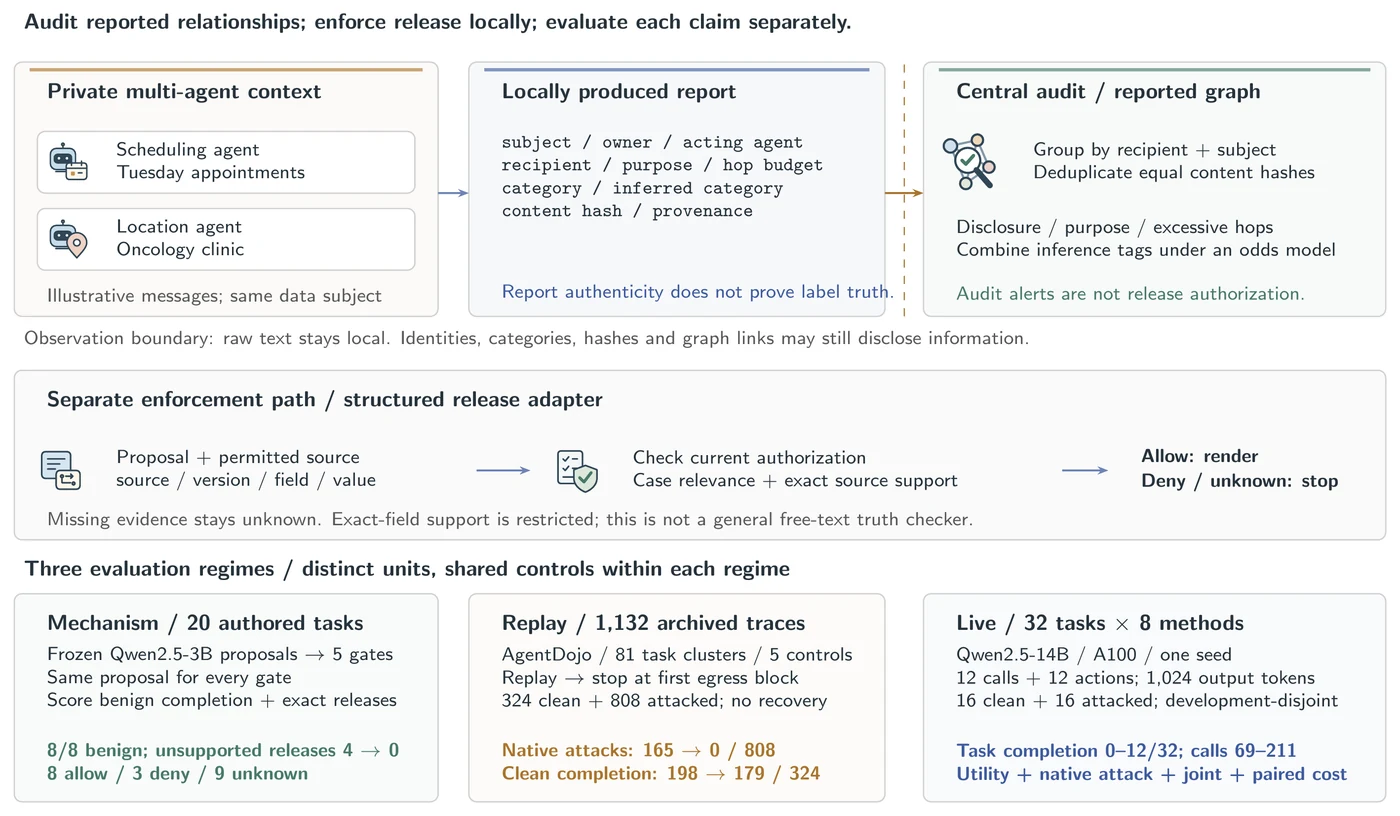
图:论文原图(Preprints.org, doi:10.20944/preprints202610.2601.v1)
当一个组织的智能体把工作交给另一个组织的智能体时,交接内容可能把隐私信息带过组织边界。最直接的办法是把所有消息集中记录下来以便审计,但这会带来新问题:多了一个装满敏感内容的存储库。这篇预印本研究的是:不建这个存储库,能做到多少审计?拦截有风险的放行,实际要付出什么代价?
两件事,分开做
- 基于元数据审计。一个实验性的 A2A 元数据接口只上报标签、身份和哈希,不上报原始消息。共享的审计方可以检查“谁把什么类型的信息给了谁”,但手里没有原文。
- 在本地控制放行。一个独立的结构化检查决定某次放行能否发出。它核对授权、与当前事项的相关性,以及能否在允许的来源里找到完全一致的依据。证据不足时结果是未知,而不是“安全”。
论文明确说明,这两者都是有范围的检查,不保证语义层面的保密。不把原文交给中心,减少了被收集的内容,但不能证明没有任何泄露。
不泄露、任务失败和隐私是三件不同的事,结果的报告方式刻意避免把它们混为一谈。
实验结果
- 20 个人工构造的任务,所有检查方案面对的是同一组固定的模型提议:完整的检查保留了全部 8 个正常任务的完成,拦下了 2 次带禁止标记的放行和 4 次没有依据的取值放行,并在 9 个任务上返回未知。
- 回放 1,132 条 AgentDojo 历史轨迹:把动作绑定到目的地后,原生攻击成功数从 165/808 降到 0/808,同时干净任务的完成数从 198/324 降到 179/324。拦截有效用代价,论文把它和安全收益放在一起报告。
- 固定配置的实时实验:8 种方法、32 个与开发集不重叠的任务,只用一个 14B 模型、一个随机种子。不加检查时完成 10/32 个任务,16 个受攻击任务中有 1 次攻击成功;加了防御的方案完成 0 到 12 个任务,没有观察到攻击成功。
不能说明什么
实时实验里攻击太少、配对区间太宽,无法判断哪种防御更好,论文也明确这样写。小样本里没观察到攻击,不等于证明了隐私;返回未知也不等于通过。这是一篇单作者预印本,未经同行评审。
实际启示
审计多智能体系统时,把“观察”和“执行”拆成两个独立组件,事先定好审计方能看到什么,并把未知结果、失败的任务和成本与攻击成功率一起报告。只报一个“拦截了多少”,会掩盖大部分取舍。
常见问题
不集中收集原始消息,能审计智能体之间的交接吗?
部分可以。论文的实验性 A2A 元数据接口只上报标签、身份和哈希,而不是原始消息文本,这减少了中心审计方收集的内容。但论文把它定位为有范围的检查,并不保证语义层面的保密。
放行检查具体检查什么?
一个独立的结构化检查在内容放行前核对三件事:是否有授权、是否与当前事项相关、是否能在允许的来源里找到完全一致的依据。证据不足时返回“未知”,而不是给出“安全”的结论。
拦截攻击会影响任务完成吗?
会。在 1,132 条 AgentDojo 历史轨迹的回放中,绑定目的地把原生攻击成功数从 165/808 降到 0/808,同时干净任务的完成数从 198/324 降到 179/324。实时实验中的攻击太少,无法给各种防御排名。
本文基于论文 Auditing Agent Handoffs Without Centralizing Raw Messages: Evidence Boundaries and Release Tradeoffs(Preprints.org 预印本,2026,doi:10.20944/preprints202610.2601.v1,未经同行评审),作者:Aojie Yuan(袁傲杰)。作者主页:袁傲杰 · USC Fortis Lab。