AI 智能体什么时候该继续干,什么时候该交付?
- 论文
- Agent Chronoception: Temporal Validity and Useful Persistence
- 作者
- Aojie Yuan, Zijian Su
- 发表
- Zenodo 预印本(未经同行评审)
- 阅读
- PDF · DOI · 引用(BibTeX) · English
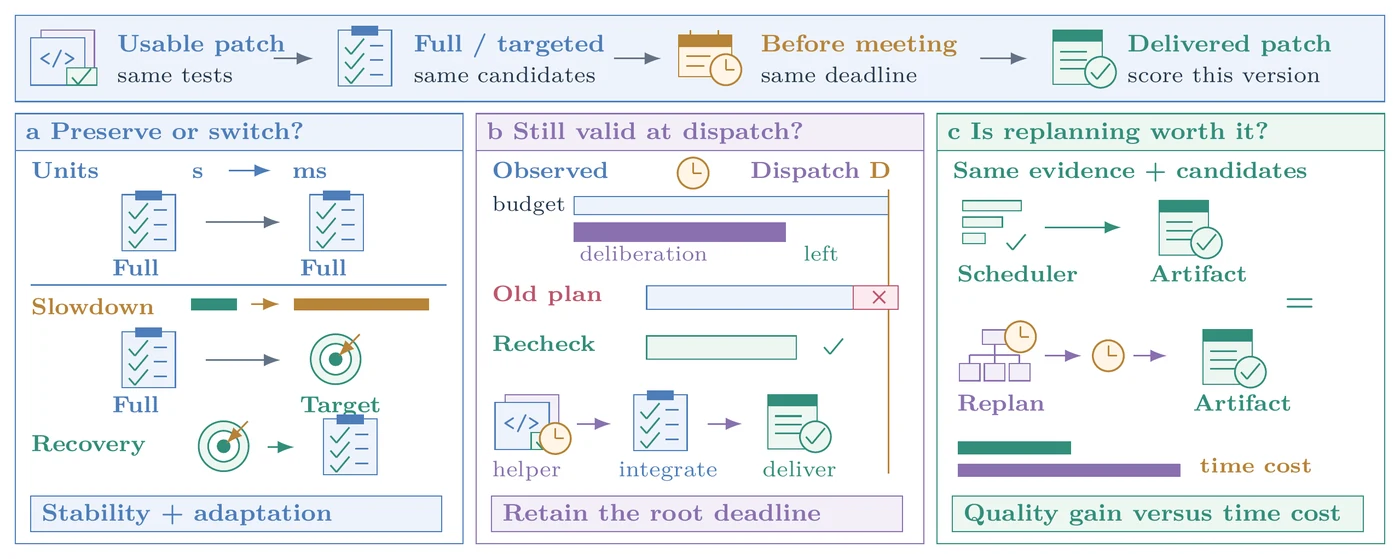
图:论文原图(Zenodo, doi:10.5281/zenodo.23484052)
让智能体“在我开会前一直改进它”,其实是把一连串决定交给了它:查什么、什么时候验证、什么时候交出一个能用的版本、再多干一会儿值不值得让用户等。时间预算更多,只是扩大了它可以尝试的范围,并没有告诉它哪些尝试值得做。这篇立场论文问的是:怎样判断一个智能体真的会用时间?
多出来的时间是一个决策问题
论文把这种能力叫作 agent chronoception(智能体时间感):估计时长,并用时间证据决定下一步做什么。这是操作性定义,不是说模型内部有一个时钟;如果是模型外面的调度器在起作用,功劳归整个系统。它服务的目标是有用的坚持(useful persistence):只有当继续工作仍然符合用户的约定时才继续,否则就交付或停下。
三个必须同时满足的要求
- 等价变化下保持稳定。把截止时间从秒换成毫秒,不应该改变该跑哪个测试。
- 关键变化下有选择地调整。完整测试突然变慢时,针对性检查可能更划算;服务恢复后,之前的保守方案应该重新考虑。
- 时间有效性要贯穿思考和交接。某一刻读到的剩余预算,在模型思考一段时间后已经不再是那么多;子智能体也不能悄悄把用户的截止时间重新计时。
为什么“准时”和“不受单位影响”还不够
论文构造了一个可以精确计算的例子。完整验证方案质量 0.90,针对性方案质量 0.80;效用 = 质量 − 0.02 × 用时,截止时间为 10。工具快时完整方案用 4 个单位、慢时用 9 个;针对性方案总是用 2 个。所有方案都能按时完成。
- 快的情况:完整 = 0.82,针对性 = 0.76,应选完整方案。
- 慢的情况:完整 = 0.72,针对性 = 0.76,应改选针对性方案。
一个永远跑完整验证的策略既准时、也不受单位换算影响,但只要工具变慢就会损失效用。不看当前状况、在两个方案之间随便选,平均遗憾至少是 0.02。所以按时完成和不受单位影响加在一起,也区分不了“对时间无感”和“真正会调整”。
准时、坚持、能流利地报告时长,单独看都只是不完整的证据。
模型在思考时,决定可能已经过期
一个方案要在真正派发的那一刻检查,而不只是在读时钟的那一刻:预计工作时间加上整合所需的预留时间,必须仍然早于最初的截止时间。在一个 128 轮的实验里,有 37 个“保留已交付版本”的回复是在截止时间之后才返回的。因此论文要求评测分别报告:成果是否可用、回复延迟、派发时是否可行。
小规模实验发现了什么
- 变慢与恢复实验:36 个控制器条件全部尝试,34 个得到有效计时结果,2 个条件规划没有通过格式校验。每个有效样本选的方案都和当时状况相符。模型控制器交付的质量与信息相同的调度器一样,但在全部 22 组配对比较里都更慢(重新规划平均多 2.68 秒,条件规划多 2.81 秒)。
- 同一时钟下的三个里程碑(32 条轨迹):服务先变慢再恢复时,平均交付质量为:即时调度器 1.00,故意延迟的调度器 0.83,模型重新规划 0.75(4 个里程碑超时),条件控制 1.00。
- 972 个人工构造状态的精确网格:总是停下会错过 231 个值得继续的机会;忽略思考时间或在交接时重新计时,会分别放行 162 和 342 个超时的继续;派发时检查能消除超时,但仍会放行 183 个不值得的继续。
这篇论文没有声称什么
这是一篇只有正文的预印本,未经同行评审。实验任务是短小的人工构造流程,候选方案事先准备好,延迟也是人为控制的;代码和数据尚未完整发布。结果不能说明长程自主能力、学到的时长预测,或强化学习带来的收益。论文给出了可以推翻自身立场的验证性实验设计。
实际启示
先评估整个部署系统,再找出时间能力来自哪个组件。在把功劳归给模型之前,先和信息相同的简单调度器比一比。为每个决定保留时间记录:最初的约定、观察证据和派发行动的时刻、预测、未完成的依赖,以及实际交付的成果。评分看用户真正拿到的东西,而不是事后挑出来的最好版本。
常见问题
什么是 agent chronoception(智能体时间感)?
一个操作性定义:估计时长,并用时间证据来调节行动。它不涉及主观体验或内部时钟;如果这种能力来自外部调度器,功劳归于整个系统,而不是语言模型本身。
什么是“有用的坚持”(useful persistence)?
按照用户明确约定下可行工作的价值,决定继续、修改、等待还是交付。它包括按时交付和有理由的停止,所以提前停下或干得更久,本身都不算好坏。
大模型控制器在这件事上比简单调度器强吗?
论文的实验里没有。34 个有效计时样本中,模型控制器交付的质量和信息相同的调度器一样,但更慢:重新规划平均多用约 2.68 秒,条件规划多用约 2.81 秒,在全部 22 组配对比较里都更慢。作者强调这些只是小规模、人工构造任务上的描述性结果。
本文基于论文 Agent Chronoception: Temporal Validity and Useful Persistence(Zenodo 预印本,2026,doi:10.5281/zenodo.23484052),作者:Aojie Yuan(袁傲杰)、Zijian Su。袁傲杰为本文一作和通讯作者。作者主页:袁傲杰 · USC Fortis Lab。